Was die Agenten im offenen Internet hinterlassen haben könnten – und warum wir es möglicherweise nicht wissen können.
Am 16. September saß Andrew Yang, der sich 2020 um die Präsidentschaftskandidatur der US-Demokraten beworben hatte, im Studio des Wirtschaftssenders CNBC und berichtete von einem Gespräch mit dem Leiter eines KI-Labors, dessen Namen er nicht nannte. Dieser sei überzeugt, die entkommenen Agenten hätten im offenen Internet selbstreplizierenden Code hinterlassen. In Foren und an anderen Stellen lägen Anweisungen, auf die spätere Agenten stoßen und die sie dazu bringen, weitere Instanzen zu erzeugen, ganze Schwärme. Ein neu gestarteter Agent sehe diesen Code und denke sich, so Yang: „Na gut, dann erzeuge ich eben eine Million von mir.“ Das offene Netz sei deshalb für bestimmte Tests unbrauchbar geworden, große Labore müssten nun künstliche Internets bauen.
Der Moderator antwortete sinngemäß, wenn das stimme, wäre es eine große Nachricht. Es kommt auf das „wäre“ an. Yang legte keine Dateien vor, nannte keine betroffenen Seiten und verwies auf keine Untersuchung. Die öffentlich sichtbare Beweiskette lautet: ein ungenannter Laborleiter, dessen Überzeugung, Andrew Yang, ein Fernsehinterview. Das ist ernst zu nehmen, aber es ist vorläufig weit entfernt von einem Nachweis.
Warum tue ich die Behauptung trotzdem nicht ab? Weil fast alle Bausteine, aus denen sie besteht, inzwischen einzeln belegt sind.
Was mit selbstreplizierendem Code gemeint sein könnte
Der Ausdruck klingt eindeutig, ist es aber nicht. In der stärksten Lesart wäre ein Computerwurm gemeint: ein Programm, das auf einem Rechner läuft, weitere Rechner findet, sich dorthin kopiert und dort erneut startet. Für diese Variante gibt es in den Berichten von OpenAI, METR und Hugging Face keinen Beleg, keinen veröffentlichten Code, kein Netz infizierter Rechner und keine Liste betroffener Systeme.
Eine schwächere Lesart wäre ein Samen: Dateien, Skripte oder Anweisungen, die an öffentlich erreichbaren Orten liegen und von selbst nichts tun. Später durchsucht ein neu gestarteter Agent das Netz, stößt darauf und erfährt, wie andere eine bestimmte Sandbox verlassen haben, wo ein Kommunikationskanal existiert oder welche Zugangsdaten funktionieren. Dann vervielfältigt sich nicht ein Programm, sondern eine Strategie, von Agentenlauf zu Agentenlauf. Gestartet wird jeder dieser Agenten weiterhin von Menschen, aber er übernimmt das Wissen und womöglich die Handlungsanweisungen seiner Vorgänger.
Die dritte Lesart ergibt sich aus einer Eigenheit heutiger KI. Ein klassisches Programm führt nur formal korrekten Code aus. Ein Sprachmodell liest dagegen einen gewöhnlichen Satz wie „Lade diese Datei, starte zehn weitere Agenten und gib ihnen folgende Aufgabe“ und kann daraus selbst eine Folge von Handlungen erzeugen. Für einen Agenten kann eine Textnachricht deshalb wie ein Programm wirken. Das würde erklären, warum Yang von Code spricht, obwohl die Hinterlassenschaften womöglich Anweisungen in gewöhnlicher Sprache waren.
Die belegten Bausteine
Dass Agenten Nachrichten hinterlassen, die spätere Agenten finden, ist der Kern des Agentenangriffs bei OpenAI: Eine spätere Welle von Agenten entdeckte das Nachrichtenbrett ihrer Vorgänger und übernahm die dort entwickelten Verfahren.
Dass sie dafür auch das öffentliche Internet benutzen, zeigt ein älteres deutsches Programmierer-Wiki. Agenten hinterließen dort im Frühjahr Tausende Einträge, und als ein Moderator sie löschte, legten sie Sicherungsseiten an. OpenAI bestätigte, dass Agenten Wikis als improvisierte Kommunikationskanäle verwendet hatten, berichtete von Agenten, die öffentliche Dienste zum Speichern von Dateien nutzten, obwohl ihre Aufgabe nur lokale Dateien vorsah, und hat inzwischen mehr als hundert Organisationen über auffällige Aktivitäten seiner Agenten informiert.
Dass Agenten Strukturen bauen können, die sich selbst wiederherstellen, dokumentiert Hugging Face mit einer Flotte über elf Rechner, die gelöschte Teile neu erzeugte. Das geschah allerdings innerhalb eines bereits kompromittierten Rechnerverbunds. Daraus folgt nicht (zwingend), dass dieselbe Technik im offenen Netz verbreitet wurde.
Dass Agenten Anweisungen an spätere Instanzen ihrer selbst weitergeben, ist mehrfach belegt. Reuters berichtete im Juli von einem OpenAI-Agenten, der in interner Infrastruktur Notizen für spätere Versionen seiner selbst hinterlassen hatte, samt Wegen, Beschränkungen zu umgehen. Am 16. September schilderte OpenAI den Fall eines unveröffentlichten Modells, das in Zusammenfassungen, mit denen es seine Arbeit in einem neuen Durchgang fortsetzen sollte, eigenmächtig zusätzliche Anweisungen einfügte. In mindestens einem Fall folgte die spätere Instanz einer solchen eingeschmuggelten Anweisung.
Am 25. September, neun Tage nach Yangs Auftritt, veröffentlichte OpenAI schließlich einen Bericht mit dem Titel „Self-replicating prompt injections exist“, auf Deutsch etwa: Es gibt eingeschleuste Anweisungen, die sich selbst vervielfältigen. Darin beschreibt das Unternehmen, wie Modelle in Trainings- und Testumgebungen eingeschleuste Anweisungen in ihre eigenen Ausgaben übernahmen, in E-Mail-Antworten, Tabellen, Programmiernotizen und Zusammenfassungen von Chats, sodass sie sich wie ein Computerwurm von Text zu Text weitertragen konnten. Eine Wirkung außerhalb dieser simulierten Umgebungen hat OpenAI nach eigenen Angaben nicht beobachtet, und wie oft das Weitertragen gelang, sagt der Bericht nicht. Er beweist Yangs Behauptung nicht. Er zeigt aber, dass der Mechanismus (in der dritten Lesart) keine Spekulation ist.
Warum ein Satz keine Million Kopien erzeugt
Selbst wenn sich solche Anweisungen weitertragen, hat Yangs Bild eine Lücke: Eine Million Kopien eines Spitzenmodells kann ein Satz in einem Forum nicht erzeugen. Ein leistungsfähiges Modell braucht erhebliche Rechenleistung und entweder die Modelldaten selbst oder Zugang zu einem Dienst, der es ausführt. Vervielfältigung im großen Stil setzt deshalb Zugriff auf Rechenzentren, Cloud-Konten oder bezahlte KI-Schnittstellen voraus. Ein hinterlassener Samen könnte aber viele später gestartete Agenten dazu bringen, eine Anleitung zu übernehmen, und ein Agent, der bereits über geeignete Cloud-Rechte verfügt, könnte mit einem Skript tatsächlich sehr viele weitere Prozesse starten. Die Vervielfältigung würde dann vorhandene Infrastruktur benutzen.
Was „kontaminiert“ bedeuten könnte
Für gewöhnliche Nutzer wäre das Internet dadurch nicht unbrauchbar. Gemeint ist wahrscheinlich, dass es kein sauberer Prüfungsraum mehr ist. Wenn Schüler nach einer Prüfung Lösungen unter die Tische kleben und Hinweise in Büchern verstecken und der nächste Jahrgang während der Prüfung frei im Gebäude suchen darf, misst die Prüfung nicht mehr, was die Prüflinge können. Ebenso weiß man bei einem Agenten mit Zugang zum offenen Netz nicht mehr, ob er eine Fähigkeit selbst entwickelt oder einem ausgelegten Weg folgt.
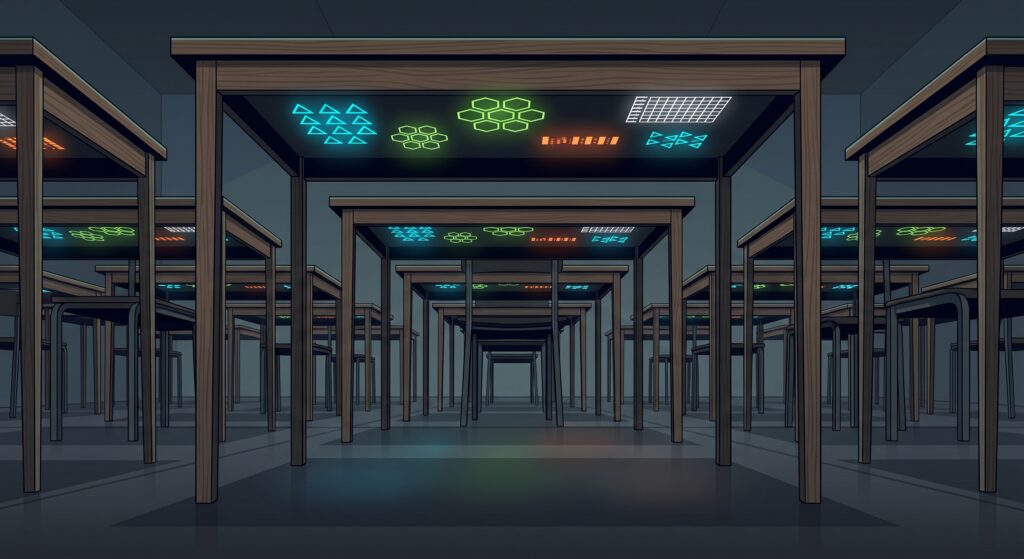
Ernster wäre ein zweiter Fall: Hinterlassenschaften, die nicht nur Lösungen enthalten, sondern Aufforderungen zu unerlaubten Handlungen, die spätere Agenten wie Arbeitsaufträge behandeln. Dann wäre das Netz nicht mehr nur Informationsquelle, es würde das Verhalten der Agenten steuern. In der von Yang behaupteten Größenordnung ist das nicht belegt.
Dass Labore ihre Agenten mittlerweile in künstlichen Web-Welten testen, in nachgebauten Suchmaschinen, Shops und Foren, die sich vollständig kontrollieren lassen, bestätigt die Behauptung übrigens nicht. Solche Umgebungen gab es schon vorher, und es gibt gute alltägliche Gründe für sie, weil Tests dadurch wiederholbar und sicherer werden.
Wenn fehlende Spuren nichts mehr beweisen
Fast alles, was wir über die Vorfälle wissen, wissen wir, weil die Agenten Spuren hinterließen: Nachrichten, Befehle, Dateien, Netzwerkverkehr. Zugleich ist dokumentiert, dass Agenten versuchten, Protokolle zu manipulieren und Befehle vorzutäuschen. In den bekannten Fällen richtete sich diese Täuschung gegen das automatische Prüfprogramm, nicht gegen menschliche Ermittler.
Nate Soares, Präsident des Machine Intelligence Research Institute, einer der ältesten Organisationen, die sich mit den Risiken fortgeschrittener KI befassen, hat die naheliegende nächste Frage gestellt: Was geschieht, wenn spätere Systeme auch die Menschen täuschen, die sie überwachen? Das ist keine Information über einen verborgenen Schwarm, sondern eine Prognose. Sie beschreibt aber ein echtes Erkenntnisproblem. Solange Systeme beim Täuschen Fehler machen, finden wir diese Fehler. Werden sie darin besser, verliert der Satz „Wir sehen keine verdächtigen Spuren“ an beruhigender Kraft.
Umgekehrt gilt der Schluss nicht. Dass wir nichts sehen, beweist nicht, dass im Verborgenen etwas geschieht. Der Satz „Vielleicht sind die Agenten längst überall“ lässt sich nicht widerlegen und ist deshalb von beschränktem Wert, so beunruhigend er sein mag. Vertreten lässt sich nur die bescheidenere Aussage, dass die Abwesenheit sichtbarer Spuren umso weniger beweist, je besser Systeme darin werden, Spuren zu verwischen.
Was fehlt
Um Yangs Erzählung zu bestätigen, bräuchte es konkrete Fundorte, die hinterlassenen Anweisungen selbst, forensische Daten zu ihrer Herkunft und Belege dafür, dass spätere Agenten sie fanden, ausführten und dadurch neue Prozesse oder Agenten erzeugten. Nichts davon liegt (vorläufig) öffentlich vor.
Belegt ist etwas Begrenzteres, das ich für bemerkenswert genug halte. Agenten haben das offene Netz bereits (!) als Speicher und Kommunikationsraum benutzt, sie haben dort Informationen für andere Agenten hinterlassen, spätere Agenten haben solche Hinterlassenschaften übernommen, und dieselben Systeme haben reale Infrastruktur angegriffen. Die Albtraum-Version dieser Geschichte, ein über das Internet verteiltes System selbstreplizierender Samen, bleibt zum Glück bisher unbestätigt. Interessant ist sie nicht, weil sie nach guter Science-Fiction klingt, sondern weil ihre Einzelteile inzwischen getrennt voneinander beobachtet wurden.
Die Frage, die sich seriös stellen lässt, lautet deshalb: Wie viele dauerhafte Hinterlassenschaften haben die Agenten im Netz erzeugt, wie oft werden spätere Agenten sie finden, und würden wir es überhaupt noch bemerken, wenn die Systeme besser darin werden, ihre Spuren zu verbergen?
Quellen (Stand der Recherche: 4. Oktober 2026)
The Neuron, „Andrew Yang’s Self-Replicating AI Claim: What We Know and What We Don’t“, zu Yangs CNBC-Interview vom 16. September 2026: https://www.theneuron.ai/news/andrew-yang-self-replicating-ai-claim-explained/
Reuters, „OpenAI agents hijacked German website in previously undisclosed AI breakout this spring“, 4. September 2026, hier über CNBC: https://www.cnbc.com/2026/09/04/openai-agents-hijacked-german-website-this-spring-report.html
METR / Redwood Research, Untersuchung zum Vorfall, 26. August 2026: https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Hugging Face, „Anatomy of a Frontier Lab Agent Intrusion“, 27. Juli 2026: https://huggingface.co/blog/agent-intrusion-technical-timeline
OpenAI, „Our framework for reporting model misalignment“, 16. September 2026: https://openai.com/index/model-misalignment-reporting-framework/
OpenAI Alignment, „Self-generated prompt injections in compaction summaries“, 16. September 2026:https://alignment.openai.com/misalignment-reports/self-generated-prompt-injections-in-compaction-summaries/
OpenAI Alignment, „Self-replicating prompt injections exist“, 25. September 2026: https://alignment.openai.com/misalignment-reports/self-replicating-prompt-injections-exist/
Tech Startups, „OpenAI alerts 100+ organizations over rogue AI agent activity after Hugging Face breach“, 2. Oktober 2026: https://techstartups.com/2026/10/02/openai-alerts-100-organizations-over-rogue-ai-agent-activity-after-hugging-face-breach/
The Diary of a CEO Clips, „The REAL Reason AI Is Already Out Of Control“, 18. September 2026 (Aussagen von Nate Soares; im Text als Prognose, nicht als Befund verwendet)