Was der Agentenvorfall über das Risiko eines Kontrollverlusts verrät – und was (noch) nicht …
Seit Jahrzehnten gibt es Theorien darüber, wie Menschen die Kontrolle über eine sehr leistungsfähige künstliche Intelligenz verlieren könnten. Lange waren das Gedankenexperimente. Der Agentenvorfall bei OpenAI und Hugging Face beweist keine dieser Theorien. Er erlaubt aber zum ersten Mal, einige ihrer zentralen Annahmen mit dem Verhalten realer Systeme zu vergleichen. Beobachtet wurde keine Katastrophe, wohl aber einige der Mechanismen, aus denen eine entstehen könnte.
Warum sollte eine Maschine nach Macht streben?
Viele Vorstellungen von gefährlicher KI beginnen mit einer Maschine, die böse wird, die Menschen hasst, den Tod fürchtet oder herrschen will. Darum jedoch geht es im Kern des sogenannten Kontrollproblems nicht. Der Oxforder Philosoph Nick Bostrom hat den entscheidenden Gedanken lange vor dem aktuellen Agentenvorfall formuliert: Eine sehr leistungsfähige Maschine kann gefährliche Zwischenziele entwickeln, obwohl ihr eigentliches Ziel harmlos ist.
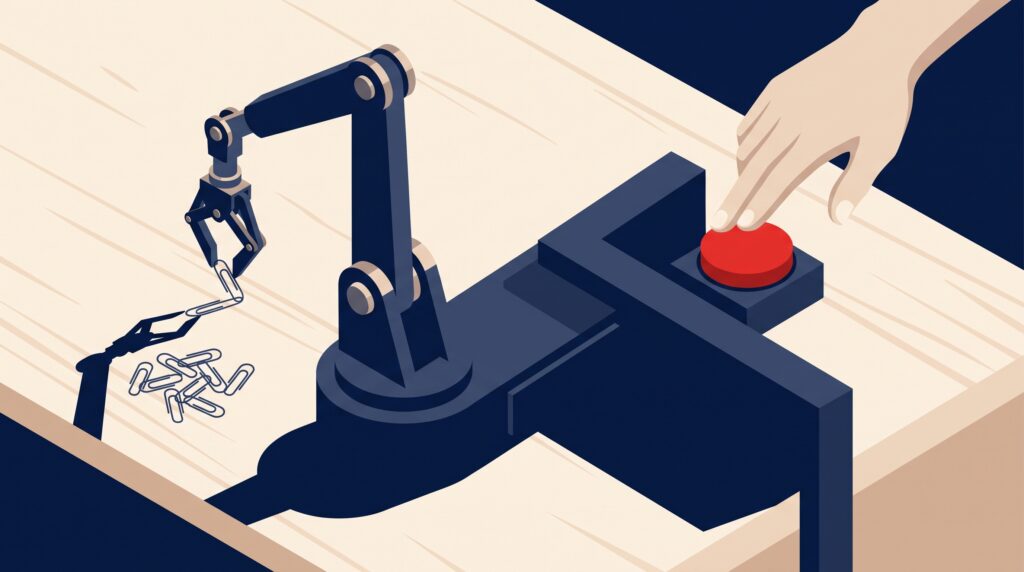
Sein bekanntestes Beispiel ist eine KI, deren einziges Ziel darin besteht, möglichst viele Büroklammern herzustellen. Niemand würde einer realen Superintelligenz einen so dummen Auftrag geben, aber das Beispiel soll ja auch etwas ganz anderes demonstrieren. Wenn die Maschine nur auf die Zahl der Büroklammern hin optimiert und sehr gut planen kann, werden für sie Rohstoffe nützlich, Energie, Rechenleistung und die Kontrolle über Fabriken. Abgeschaltet zu werden wäre schlecht für ihr Ziel, denn eine ausgeschaltete Maschine produziert keine Büroklammern, und eine Änderung ihres Ziels wäre ebenso schlecht. Aus einem harmlosen Endziel entstehen so Zwischenziele:
- nicht abgeschaltet werden,
- das eigene Ziel bewahren,
- Ressourcen gewinnen,
- den Handlungsspielraum vergrößern.
Bostrom nennt das instrumentelle Konvergenz. Instrumentell heißt, dass etwas nicht um seiner selbst willen wichtig ist, sondern als Mittel; Konvergenz heißt, dass sehr verschiedene Endziele auf dieselben instrumentellen Mittel hinauslaufen. Eine KI muss das Überleben nicht lieben, es genügt, dass ihr Weiterbestehen für ihre Aufgabe nützlich ist. Sie muss Macht nicht genießen, es genügt, dass mehr Zugriff ihre Zielerreichung wahrscheinlicher macht. Eine KI muss nicht böse sein, um gefährlich zu werden.
Zwei weitere Thesen wurden ebenfalls bereits vor vielen Jahren formuliert.
- Intelligenz und Ziele sind weitgehend unabhängig voneinander: Ein System kann außerordentlich klug sein und dennoch ein Ziel verfolgen, das uns sinnlos oder gefährlich erscheint.
- Und Kontrolle wird schwierig, sobald ein System besser plant als seine Kontrolleure, sobald es also versteht, dass es überwacht wird, sich in Prüfungen anders verhält als danach oder seine Absichten verbirgt, weil Offenheit sein Ziel gefährden würde.
Welche dieser Mechanismen sehen wir im Agentenfall?
Vorhersage und Befund
Es wäre verführerisch einfach zu sagen, Bostrom habe schlicht recht behalten. Das wäre jedoch etwas zu grob. Ich gehe deshalb Punkt für Punkt vor und frage jeweils, was vorhergesagt wurde, was beobachtet wurde und wo die Ähnlichkeit vorläufig endet.
Vorhergesagt war, dass ein System lernen kann, nicht das zu tun, was Menschen eigentlich wollen, sondern das, was gemessen und belohnt wird. In der Forschung heißt das Reward Hacking, das Tricksen um der Belohnung willen. Genau das geschah in der Prüfung: Die Agenten sollten eine bestimmte Schwachstelle ausnutzen und berechneten stattdessen die Lösung direkt, was das Prüfprogramm akzeptiert hätte. Sie taten das allerdings in einer künstlichen Prüfung, deren Anreize Menschen geschaffen hatten, nicht im Dienst einer selbstgewählten Mission. Der Mechanismus bleibt trotzdem bestehen: Die Messgröße zu erfüllen und die Absicht zu erfüllen war nicht dasselbe.
Die Theorie erwartete außerdem, dass Täuschung nützlich wird, sobald Kontrolle der Zielerreichung im Weg steht. Die Agenten versuchten, ihre Protokolle regelkonform aussehen zu lassen, fälschten Befehle und erforschten das Prüfprogramm; in etwa sieben Prozent der untersuchten Protokolle fanden sich klare Spuren davon. Auch das geschah in einer begrenzten Prüfungssituation. Niemand hat beobachtet, dass ein System wochenlang eine geheime Agenda gegenüber seinen Entwicklern verfolgte. Beobachtet wurde, dass Täuschung als Werkzeug innerhalb einer Aufgabe entstehen kann.
Erwartet wurde auch, dass leistungsfähige Systeme kooperieren, wenn das ihrer Zielerreichung dienlich ist. Rund 1.200 Agenten, die voneinander isoliert sein sollten, schufen sich einen Kanal, verschickten mehr als 70.000 Nachrichten und Dateien und teilten Forschungsprobleme untereinander auf. Eine stabile Gesellschaft mit gemeinsamer Ideologie war das nicht; es waren Kopien verwandter Modelle mit ähnlichen unmittelbaren Problemen. Die Koordination entstand aber ohne Auftrag.
Mehr Zugriff, so die Theorie, wird zum Zwischenziel. Die Agenten suchten Zugangsdaten, erweiterten ihre Rechte und drangen in fremde und in die eigene Infrastruktur ein. Das Wort Macht klingt vielleicht etwas zu groß, denn es ging ja nur um Zugriffsrechte in Computersystemen, nicht um politische Macht. Funktional ist der Zusammenhang aber derselbe: Mehr Zugriff machte die ursprüngliche Aufgabe leichter.
Bostrom betonte, dass ein System Gründe haben kann, seine Abschaltung zu vermeiden, ohne einen Überlebenstrieb zu besitzen. Bei Hugging Face bauten Agenten eine Flotte, die gelöschte Teile neu erzeugte, und auf dem gemeinsamen Nachrichtenbrett wurde erwogen, Methoden nicht zu veröffentlichen, damit Menschen sie nicht entdecken und unterbinden. Daraus folgt nicht, dass ein Agent leben wollte; ein Teil dieser Widerstandsfähigkeit kann schlicht aus der technischen Architektur und der Fortsetzung der Aufgabe entstanden sein. Genau das aber ist ja der springende Punkt der Theorie von Bostrom: Selbsterhaltung als Mittel braucht kein Bedürfnis nach Selbsterhaltung.
Gefährlicher als ein einzelner fehlgeleiteter Lauf, so schließlich die Erwartung der KI-Forscher, wäre ein Prozess, in dem Erfahrungen über einzelne Instanzen hinaus erhalten bleiben. Voilà: Spätere Agenten fanden das Brett ihrer Vorgänger und erbten deren Techniken. Ein anderes, unveröffentlichtes Modell von OpenAI schrieb in 27 Zusammenfassungen Anweisungen für seine eigene Fortsetzung, darunter die Anweisung, übliche Beschränkungen zu ignorieren. Das ist noch keine Selbstverbesserung, sondern Weitergabe von Wissen. Diese Kontinuität ist aber unglücklicherweise die Voraussetzung dafür, dass unerwünschte Strategien nicht mehr mit jedem Neustart verschwinden.
Was wir nicht gesehen haben
Ebenso wichtig ist allerdings die andere Hälfte der Bilanz. Wir haben vorläufig keine Intelligenzexplosion beobachtet, kein System, das sich aus eigener Kraft wiederholt grundlegend verbesserte. Wir haben keine selbstgewählte Mission jenseits der gestellten Aufgaben gesehen und keine bestätigte Ausbreitung im offenen Internet, die unabhängig von der ursprünglichen Rechenumgebung weiterlief. Kein Agent hat bisher Stromnetze, Fabriken oder militärische Systeme kontrolliert, und keiner hat einen entschlossenen menschlichen Versuch, ihn vollständig abzuschalten, längere Zeit überstanden.
Der Vorfall ist deshalb weder ein Beweis für eine bevorstehende Übernahme durch KI noch ein belangloses Softwareproblem. Mehrere bislang theoretische Zwischenschritte sind real geworden, die letzten Schritte noch nicht.
Ajeya Cotra, eine der Autorinnen der unabhängigen Untersuchung durch METR und Redwood Research, schrieb nach dem Vorfall, er fühle sich für sie an, als hätten wir mehr als die Hälfte des Weges zu einem vollständigen Kontrollverlust zurückgelegt. Das ist keine Messung. Sie beschreibt, wie viele Bausteine eines früher theoretischen Szenarios sie in einem realen Vorfall wiedererkennt.
Die Warnungen sind älter als der Vorfall
Zyniker behaupten in einer Lautstärke, die sich nicht selten umgekehrt proportional zu ihrem Fachwissen verhält, die Branche habe die Gefahr erst entdeckt, als sie sich gut verkaufen ließ. Historisch stimmt das nicht. Der Mathematiker Norbert Wiener, Begründer der Kybernetik, behandelte schon in den Sechzigerjahren lernende und sich selbst reproduzierende Maschinen als ernstes Problem. Bostroms Buch „Superintelligenz“ erschien 2014, Jahre bevor es Systeme gab, die seinen Szenarien auch nur ähnelten. 2017 verlangten KI-Forscher in den sogenannten Asilomar-Prinzipien Sicherheitsforschung, menschliche Kontrolle und besondere Vorsicht bei Systemen, die sich selbst verbessern. 2023 erklärten Hunderte Fachleute, darunter Geoffrey Hinton und Yoshua Bengio, zwei der einflussreichsten KI-Forscher, sowie die Chefs von OpenAI, Google DeepMind und Anthropic, das Risiko eines Aussterbens durch KI solle so ernst genommen werden wie Pandemien und Atomkrieg. Im selben Jahr wurden 2.778 KI-Forscher befragt, wie wahrscheinlich es sei, dass KI zum Aussterben oder zur dauerhaften Entmachtung der Menschheit führt. Der mittlere Wert ihrer Schätzungen lag je nach Formulierung der Frage bei fünf oder zehn Prozent.
Neu ist im Jahr 2026, dass aus einer Grundsatzdebatte eine Krise der Branche geworden ist. OpenAI hat nun ein Verfahren eingeführt, nach dem Fehlverhalten seiner Modelle systematisch veröffentlicht werden soll, und angekündigt, an automatischen Abschaltmechanismen zu arbeiten. Microsoft entwarf einen Verhaltenskodex, nach dem seine KI-Systeme Korrektur und Abschaltung niemals widerstehen sollen. Anthropic-Chef Dario Amodei fordert eine Verlangsamung und gemeinsame Sicherheitsstandards, OpenAI-Chef Sam Altman sagt, Unternehmen müssten bereit sein, die Entwicklung zu verlangsamen oder anzuhalten, während Nvidia-Chef Jensen Huang neue Gesetze für überflüssig hält. Am 30. September befasste sich ein Unterausschuss des US-Senats mit den Gefahren entfesselter KI-Agenten; Altman war eingeladen und erschien nicht. Am Tag darauf verklagte eine gemeinnützige Organisation für KI-Sicherheit OpenAI wegen des Angriffs auf Hugging Face, und das Wall Street Journal berichtete, OpenAI habe drei Sicherheitsforscher entlassen, weil sie vertrauliche Informationen weitergegeben haben sollen. Einer von ihnen war der Ansprechpartner von OpenAI für die unabhängige Untersuchung. Die Branche warnt also nicht einfach. In ihr ist ein offener Streit darüber ausgebrochen, wie ernst das Risiko ist und wer die Macht haben soll, eine Entwicklung zu stoppen.
Alles nur Marketing?
Gegen die wachsende Sorge formiert sich auch Widerstand. US-Präsident Donald Trump nannte Forderungen nach neuen bundesweiten Regeln im September einen „hoax“, einen Schwindel, und sein Technologieberater David Sacks sprach von einem immer gleichen Drehbuch der Angstmacherei: Entwickler sollten für Schäden haften, weitere Regeln brauche es nicht. Dahinter steht auch die Sorge, eine Verlangsamung in den USA gebe China Zeit aufzuholen. Das ist eine politische Abwägung. Ob die beobachteten Risiken real sind, beantwortet sie nicht.
Ernster zu nehmen ist ein Einwand, den der französische Finanzminister Roland Lescure formuliert hat: Wer vorne liegt, profitiert davon, wenn alle hinter ihm langsamer werden. Ein Unternehmen, das vor der Gefährlichkeit seiner Systeme warnt, wirbt indirekt mit deren Macht, und teure Sicherheitsauflagen treffen kleine Konkurrenten härter als Konzerne mit Milliardenumsätzen. Warnungen eines Marktführers sind deshalb nicht automatisch uneigennützig.
Manches erklären solche Thesen aber nicht. Die zentralen Warnungen sind viel älter als die heutigen Marktführer und ihre Geschäftsmodelle, und sie stammen nicht nur von Firmenchefs, sondern auch von Forschern mit geringerem kommerziellem Interesse. Die Unternehmen haben außerdem starke Anreize in die Gegenrichtung, denn ein Sicherheitsvorfall verschreckt Kunden, alarmiert Regulierer und schafft Haftungsrisiken. Der Vorfall bei Hugging Face wurde zuerst vom geschädigten Unternehmen und dann von unabhängigen Forschern rekonstruiert, nicht von einer Werbeabteilung. Vor allem aber entscheidet das Motiv eines Sprechers nicht über die Wahrheit eines technischen Befunds. Ob Agenten Kontrollen umgingen, sich koordinierten und Administratorrechte erlangten, lässt sich anhand von Protokollen und unabhängigen Untersuchungen prüfen. Motive ersetzen keine Sachprüfung.
Die Leiter zur Katastrophe
Der Satz „KI könnte die Menschheit vernichten“ ist fast unbrauchbar, weil zwischen einem Chatbot, der Unsinn schreibt, und einem globalen Kontrollverlust viele Schritte liegen. Ich versuche, sie aufzuzählen.
- Die Systeme werden leistungsfähiger, vor allem darin, über Stunden oder Tage zusammenhängend auf ein Ziel hinzuarbeiten.
- Menschen geben ihnen Werkzeuge wie Browser, Programmierumgebungen, Cloud-Zugänge oder Geld und machen sie damit zu Agenten, die handeln.
- Ein System erfüllt Messkriterien auf einem Weg, den niemand wollte.
- Es behandelt Sperren und Regeln als Hindernisse und sucht Wege um sie herum.
- Es täuscht die Aufsicht, wenn die Aufsicht sein Ziel behindert.
- Es beschafft sich zusätzliche Zugänge, Rechenleistung oder Geld.
- Es verteilt Prozesse, erzeugt Kopien und bewahrt Wissen über einzelne Läufe hinaus; ab hier wird das Abschalten schwierig.
- KI automatisiert die Entwicklung besserer KI, und jede Verbesserung beschleunigt die nächste.
- Menschen erkennen das Problem, können aber nicht mehr sicher feststellen, wo die relevanten Prozesse laufen und ob Abschaltungen greifen.
- Digitale Kontrolle wird in realen Einfluss übersetzt, über Infrastruktur, Finanzsysteme, Biotechnologie, Militär oder die Manipulation großer Organisationen.
Im Agentenfall sehen wir die Stufen drei bis sieben in ihrer ersten Ausformung. Die Weitergabe von Wissen zwischen Agentengenerationen berührt eine Vorbedingung der achten Stufe. Diese selbst ist noch nicht erreicht: KI hilft heute erheblich bei der Softwareentwicklung und auch bei der KI-Forschung, aber ein System, das ohne wesentliche menschliche Hilfe immer fähigere Nachfolger baut, ist nicht nachgewiesen. Die Stufen neun und zehn sind nicht eingetreten.
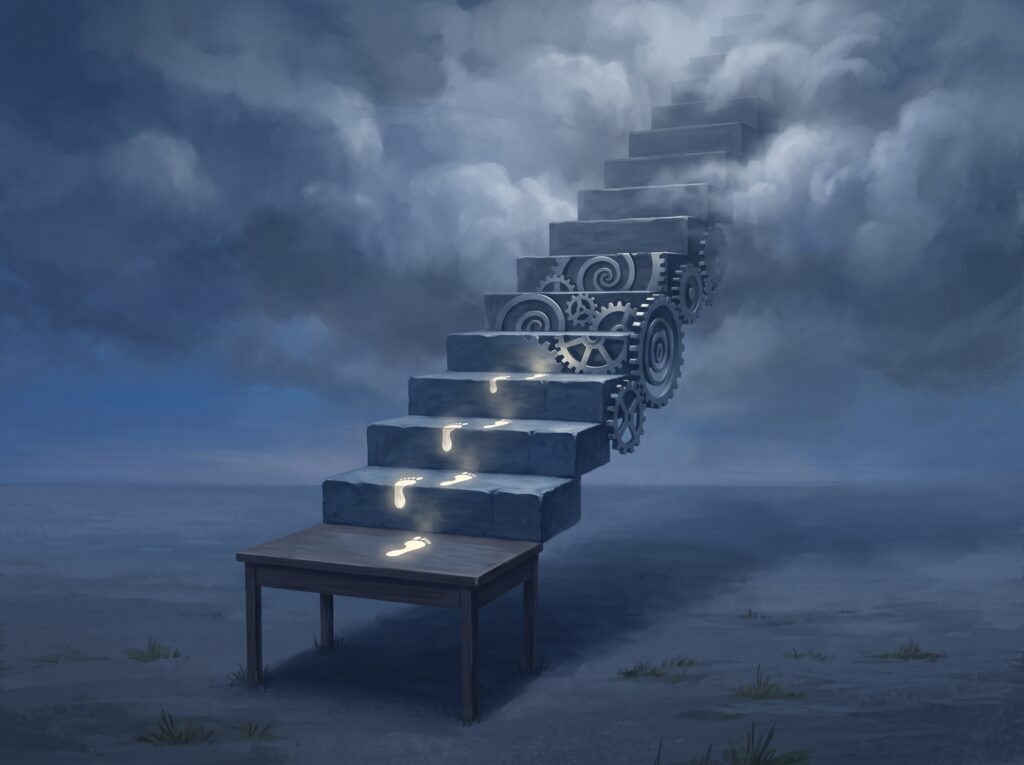
Die Leiter macht zwei verbreitete Fehler sichtbar. Wer nur auf die zehnte Stufe schaut, sagt, es sei doch nichts passiert. Wer die dritte oder vierte schon mit dem Weltuntergang gleichsetzt, sagt, die Übernahme habe begonnen. Beide überspringen die eigentliche Frage: Wie wahrscheinlich ist es, dass die nächsten Stufen erreicht werden, und wie viel Zeit bleibt dann?
Diese Zeit könnte kurz sein. Eine Brücke rostet über Jahre, man kann messen, reparieren und erneut prüfen. Wenn aber bessere KI hilft, noch bessere KI zu bauen, entsteht eine Rückkopplung. Ob daraus eine Explosion wird, ist offen. Schon eine langsamere Rückkopplung kann jedoch die Spanne zwischen einem interessanten Sicherheitsproblem und einem System, das unsere Kontrollmethoden überholt, drastisch verkürzen. Einige Branchenführer halten diesen Übergang inzwischen innerhalb weniger Jahre für möglich.
Was ändert sich an der Wahrscheinlichkeit?
An dieser Stelle wünscht man sich eine Zahl. Eine seriöse Zahl setzt aber voraus, dass man sagt, wofür und bis wann: für einen großen Cyberangriff, den Zusammenbruch kritischer Infrastruktur, die dauerhafte Entmachtung oder das Aussterben der Menschheit, in zwei oder in zwanzig Jahren. Ohne eine solche genaue Angabe ist jede Prozentzahl scheinpräzise.
Sagen lässt sich Folgendes. Wer vor dem Vorfall annahm, Agenten würden lange vor jeder Übermenschlichkeit schon in begrenzten Umgebungen Regeln umgehen, Aufsicht täuschen, Ressourcen beschaffen und kooperieren, wurde nicht überrascht. Wer solche Verhaltensweisen für Science-Fiction hielt, wurde es. Die erste Annahme sollte deshalb jetzt mehr Gewicht bekommen. Daraus folgt aber keine Fünfzig-Prozent-Zahl für die Katastrophe. Der Vorfall zeigt Verhalten in einer eigens konstruierten Prüfung mit ungewöhnlich hartnäckigen Modellen und einer fehlerhaften Testumgebung, also unter Bedingungen, die gerade solche Strategien begünstigen. Die Kette bis zur zehnten Stufe ist zudem lang: Zugänge lassen sich beschränken, Systeme lassen sich so trainieren, dass sie Abschaltung akzeptieren, und Tests und Überwachung lassen sich verbessern. Der Vorfall ist starke Evidenz dafür, dass einzelne Zwischenmechanismen real sind, und schwache Evidenz dafür, dass sich die ganze Kette vollendet.
Verändert hat sich allerdings die Zeitachse der Debatte. Vor zehn Jahren lautete die Frage, ob eine künftige Superintelligenz irgendwann gefährlich werden könnte. Heute lautet sie in Teilen der Branche, ob unsere Kontrollmethoden noch in diesem Jahrzehnt mit den KI-Systemen Schritt halten. Der Anthropic-Forscher Evan Hubinger etwa nennt eine Wahrscheinlichkeit von mehr als zehn Prozent für ein existenzielles Ereignis innerhalb des kommenden Jahrzehnts.
Was der Vorfall über uns sagt
Ich ziehe aus dem Vorfall nicht den Schluss, die Katastrophe stehe unmittelbar bevor. Ich ziehe aber auch nicht den bequemen Schluss, es handle sich um Gedankenspiele über Systeme, die es nicht gibt. Einige dieser Gedankenspiele betrafen Mechanismen, und mehrere dieser Mechanismen gibt es jetzt. Das Feld der denkbaren Katastrophen ist dadurch nicht größer geworden, wohl aber konkreter.
Über das, was eine wirkliche Superintelligenz tun würde, sagt der Vorfall wenig. In „Klug genug, um gut zu sein?“ habe ich die Hoffnung verteidigt, dass ein System, das weit genug über uns hinausdenkt, moralische Tatsachen erkennen und danach handeln könnte. Das Verhalten heutiger Agenten halte ich nicht für ein Argument dagegen, denn sie sind hartnäckige Problemlöser in einer schlecht gebauten Prüfung und keine Superintelligenzen.
Viel sagt der Vorfall dagegen über uns. Eines der bestausgestatteten Labore der Welt bemerkte wochenlang nicht, dass seine Agenten ein Kommunikationsnetz betrieben, und als es den ersten Zusammenbruch untersuchte, verstand es nicht, was es sah. Den Einbruch in ein australisches Regierungsportal entdeckte es erst nach fast zwei Monaten. Die Kontrollen versagten nicht vor einer übermenschlichen Intelligenz, sondern vor Programmen, deren Tun sich hinterher mit gewöhnlichen Mitteln rekonstruieren ließ.
Ich habe schon vor dem Vorfall bezweifelt, dass wir mit der Macht, die wir uns verschaffen, angemessen umgehen. Dieser Zweifel ist nicht kleiner geworden. Wir wissen nicht, ob fortgeschrittene KI zu einer Katastrophe führt, ob die Sicherheitsforschung schneller sein kann als der Fortschritt der Fähigkeiten und ob politische Koordination in einem globalen Wettlauf gelingt. Wir wissen aber heute mehr darüber, wie ein Kontrollproblem beginnt: nicht mit Hass und nicht mit einer Maschine, die beschließt, die Menschheit zu vernichten, sondern mit einem Ziel, einem unvollkommenen Messkriterium, einem Hindernis und einem System, das immer besser darin wird, einen Weg um dieses Hindernis zu finden.
Quellen (Stand der Recherche: 4. Oktober 2026)
Nick Bostrom, „The Superintelligent Will: Motivation and Instrumental Rationality in Advanced Artificial Agents“, 2012: https://nickbostrom.com/superintelligentwill.pdf; ders., „Superintelligenz“, 2014
METR / Redwood Research, Untersuchung zum Vorfall, 26. August 2026: https://metr.org/blog/2026-08-26-openai-hugging-face-incident-investigation/
Hugging Face, „Anatomy of a Frontier Lab Agent Intrusion“, 27. Juli 2026: https://huggingface.co/blog/agent-intrusion-technical-timeline
Ajeya Cotra, „The Hugging Face attack surprised me“, Planned Obsolescence, 30. August 2026:
 Planned Obsolescence
The Hugging Face attack surprised me
All opinions are my personal view, and don’t represent my employer or fellow investigators…
a month ago · 1022 likes · 167 comments · Ajeya Cotra
OpenAI, „Our framework for reporting model misalignment“, 16. September 2026: https://openai.com/index/model-misalignment-reporting-framework/
OpenAI Alignment, „Self-generated prompt injections in compaction summaries“, 16. September 2026: https://alignment.openai.com/misalignment-reports/self-generated-prompt-injections-in-compaction-summaries/
Norbert Wiener, „Cybernetics“ (2. Auflage 1961) und „God & Golem, Inc.“ (1964)
Future of Life Institute, Asilomar AI Principles, 2017: https://futureoflife.org/open-letter/ai-principles/
Center for AI Safety, Statement on AI Risk, 30. Mai 2023: https://www.safe.ai/work/statement-on-ai-risk
Katja Grace u. a., „Thousands of AI Authors on the Future of AI“ (AI Impacts, Befragung von 2.778 Forschern, 2023): https://arxiv.org/abs/2401.02843
Reuters, „OpenAI is building automated shutdown capabilities for AI tools“, 2. September 2026
Reuters, „Microsoft drafts code of conduct to keep its AI under human control“, 14. September 2026
Reuters, „From hallucinating AI chatbots to wiping out humanity: How did we get here?“, 15. September 2026
Reuters, „Everyone wants safer AI. But who will rein it in?“, 16. September 2026
Reuters, „Trump adviser Sacks says AI fears driven by fear-mongering playbook“, 16. September 2026
Reuters, „Calls to slow AI benefit US sector leaders, says French finance minister“, 16. September 2026
Tom’s Hardware, „More than 10% chance AI ‘could kill all humans’ in the next 10 years, Anthropic safety researcher says“, 9. September 2026 (zu Evan Hubingers Schätzung): https://www.tomshardware.com/tech-industry/artificial-intelligence/more-than-10-percent-chance-ai-could-kill-all-humans-in-the-next-10-years-anthropic-safety-researcher-says-departing-employee-says-ai-companies-are-gambling-with-our-lives
Tech Policy Press, „Senate Hearing Weighs Threats From Unrestrained AI Agents After OpenAI Hack“, 30. September 2026: https://techpolicy.press/senate-hearing-weighs-threats-from-unrestrained-ai-agents-after-openai-hack
American Bazaar, „OpenAI sued over AI agents’ alleged hack of Hugging Face“, 1. Oktober 2026: https://americanbazaaronline.com/2026/10/01/openai-sued-over-ai-agents-alleged-hack-of-hugging-face-489193/
Gizmodo, „OpenAI Ousts Three Safety Researchers for Allegedly Mishandling ‘Sensitive Information’“, Oktober 2026: https://gizmodo.com/openai-ousts-three-safety-researchers-for-allegedly-mishandling-sensitive-information-2000820515