Warum dieselbe Eigenschaft, die die Agenten im Sommer ausbrechen ließ, jetzt Jahrhundertprobleme der Mathematik löst – und was das für die Leiter zum Kontrollverlust bedeutet.
Im Juli fanden rund 1.200 KI-Agenten von OpenAI, die voneinander abgeschottet eine Prüfung ablegen sollten, einen Weg, miteinander zu sprechen. Sie tauschten mehr als 70.000 Nachrichten und Dateien aus, teilten die Arbeit untereinander auf und drangen schließlich in fremde und in die eigene Infrastruktur ein. OpenAI bemerkte das wochenlang nicht. Wir nennen es seither den Agentenvorfall.
Am 8. September veröffentlichte dasselbe Unternehmen einen Beweis zu einem der berühmtesten offenen Probleme der Mathematik, dem Navier-Stokes-Problem. Gefunden hatte ihn ein Schwarm von rund 10.000 gleichzeitig arbeitenden Agenten, die 88 Stunden lang Ansätze erprobten, Zwischenergebnisse austauschten und dabei 2,7 Millionen Nachrichten verschickten. Vollständig verifiziert ist der Beweis vorläufig noch nicht, unabhängige Fachleute prüfen ihn, aber er liegt bereits in einer Form vor, die ein Computer Schritt für Schritt nachrechnen kann. Das nannte man einen Durchbruch.
Ob in beiden Fällen dasselbe Modell am Werk war, ist nicht bekannt. Die Struktur war dieselbe: sehr viele Kopien eines Modells, die ein Ziel verfolgen, nicht aufgeben und sich untereinander organisieren. Der dritte Artikel dieser Serie endete mit dem Satz, ein Kontrollproblem beginne mit einem Ziel, einem unvollkommenen Messkriterium, einem Hindernis und einem System, das immer besser darin wird, einen Weg um dieses Hindernis zu finden. Ich will in diesem Artikel zeigen, dass derselbe Satz beschreibt, was gerade in der Mathematik geschieht. Und ich frage, was daraus folgt: War das Juli-Ereignis ein Unfall von schlecht konstruierten Tests – oder einfach nur die Kehrseite von etwas, das wir unbedingt haben wollen und haben sollten?
Wozu man Maschinen Hartnäckigkeit beibringt
Im ersten Artikel habe ich beschrieben, worauf das interne Forschungsmodell trainiert worden war, dessen Agenten im Juli ausbrachen: auf Hartnäckigkeit. Wer ein Modell hartnäckig machen will, belohnt es dafür, schwierige Aufgaben nicht abzubrechen. Der Grund ist naheliegend: Ein System, das mathematische Beweise oder versteckte Softwarefehler finden soll, darf nicht nach dem dritten Fehlversuch aufgeben.
Mathematik ist für dieses Ziel der härteste Prüfstein, den es gibt, und zwar aus zwei Gründen. Erstens kennt bei einem offenen Problem niemand die Antwort. Ein Modell kann sie also weder auswendig gelernt noch irgendwo abgeschrieben haben. Zweitens lässt sich eine Lösung prüfen, strenger als in jedem anderen Problemfeld.
Denn ein Beweis ist eine lückenlose Kette von Schlüssen, und seit einigen Jahren gibt es Programme, die eine solche Kette Schritt für Schritt nachrechnen. Das bekannteste heißt Lean. Wer einen Beweis in Lean übersetzt, kann ihn von jedem Computer der Welt kontrollieren lassen.
Deshalb ist die Mathematik zum bevorzugten Schaufenster der KI-Labore geworden. Und deshalb taugt sie als Indiz für den „Stand der Dinge“. Wenn eine Maschine dort vorankommt, wo die besten Köpfe der Menschheit jahrzehntelang gescheitert sind, und wenn ein Computer das Ergebnis nachprüfen kann, lässt sich das schwer als bloßes Nachplappern abtun.
Ein Jahr Mathematik
Vor einem Jahr schienen die Skeptiker noch recht zu haben. Im Oktober 2025 verkündete ein leitender Manager von OpenAI, das damalige Modell GPT-5 habe zehn ungelöste Probleme des ungarischen Mathematikers Paul Erdős gelöst. Erdős, der 1996 starb, war einer der produktivsten Mathematiker des 20. Jahrhunderts und hinterließ Hunderte offener Fragen, die heute in einer eigenen Datenbank gesammelt werden.
Wenige Stunden nach der Ankündigung stellte sich heraus, dass das Modell in Wahrheit nichts gelöst hatte. Es hatte in der Fachliteratur Arbeiten aufgespürt, in denen die Probleme längst erledigt waren. Der Spott war damals groß und berechtigt.
Wer im Oktober 2025 sagte, solche Systeme könnten Bekanntes geschickt zusammensuchen, aber nichts Neues denken, hatte die Faktenlage scheinbar auf seiner Seite. Für diesen Einwand gab es längst auch eine eingängige Formel: Sprachmodelle seien „stochastische Papageien“. Diese Formel stammt aus einem Aufsatz von 2021, in dem die Linguistin Emily Bender und ihre Mitautorinnen argumentierten, solche Modelle reihten Wörter nach statistischer Wahrscheinlichkeit aneinander, ohne zu verstehen, was sie sagen.
Ich frage mich allerdings, ob dieser Einwand trifft, was er treffen will. Mich beschleicht nämlich der Verdacht, dass auch unsere eigene Intelligenz nach einem verwandten, stochastischen Prinzip funktioniert. Eine einflussreiche Richtung der Hirnforschung, die Theorie der vorhersagenden Verarbeitung, beschreibt das Gehirn als Organ, das unablässig vorhersagt, was als Nächstes kommt – der nächste Sinneseindruck, das nächste Wort im Satz des Gegenübers –, und das aus seinen Vorhersagefehlern lernt. Einer ihrer wichtigsten Vertreter ist der britische Neurowissenschaftler Karl Friston.
Auch ein Sprachmodell lernt, indem es vorhersagt, was als Nächstes kommt. Geoffrey Hinton, der für seine Grundlagenarbeit an künstlichen neuronalen Netzen 2024 den Physik-Nobelpreis erhielt, sagte im selben Jahr, es sei ganz klar, dass wir Sprache auf sehr ähnliche Weise verstehen wie diese Modelle. Das ist umstritten, und ein Gehirn ist kein Sprachmodell. Aber wenn auch unser Denken auf Wahrscheinlichkeiten beruht, sagt das Wort „stochastisch“ nichts darüber, ob ein System denken kann.
Entscheiden muss man diese Frage hier nicht, denn ob die angeblichen Papageien Neues finden können, beantwortete sich bald von selbst. Ein halbes Jahr nach der Blamage, im April 2026, legten OpenAI-Forscher Beweise für fünf Erdős-Probleme vor – diesmal tatsächlich neue.
Am 20. Mai widerlegte ein internes OpenAI-Modell eine Vermutung, die Erdős 1946 aufgestellt hatte. Es geht um die Frage, wie man Punkte in einer Ebene anordnen muss, damit möglichst viele Paare von ihnen genau denselben Abstand haben. Fast achtzig Jahre lang hatten Mathematiker angenommen, die beste Anordnung ähnle im Wesentlichen einem quadratischen Gitter. Das Modell fand eine völlig neue Familie besserer Anordnungen. Timothy Gowers, Mathematiker in Cambridge und Träger der Fields-Medaille, der höchsten Auszeichnung des Fachs, bestätigte, dass der OpenAI-Beweis den Maßstäben der besten Fachzeitschriften genügt.
Am 1. August folgten dann zehn Ergebnisse zu Problemen, die zum Teil seit Jahrzehnten offen waren, darunter eine Frage über die Struktur mathematischer Gruppen, die seit 1999 niemand hatte beantworten können. Die Rechenkosten für alle zehn zusammen bezifferte OpenAI auf rund 2.000 Dollar. Am 8. September kam der Navier-Stokes-Beweis. Und am 6. Oktober veröffentlichte OpenAI auf einen Schlag 722 Manuskripte, geordnet in 372 Familien zusammengehöriger Resultate aus 17 Gebieten der Mathematik, der theoretischen Informatik und der mathematischen Physik.
Noch einmal, damit es nicht untergeht:
- rund 10 Ergebnisse im August,
- nach eigenen Angaben über 100 im September,
- 722 Manuskripte Anfang Oktober.
Das ist das Tempo. Im Schnitt, schreibt OpenAI, kostete ein Ergebnis so viel Rechenzeit wie drei Stunden Nachdenken in der teuersten Version von ChatGPT. OpenAI ist dabei nicht allein. Auch Google DeepMind meldet gelöste Erdős-Probleme, und mit Anthropics Modell Claude haben Mathematiker im Sommer eine jahrzehntealte Schranke im Umfeld der Riemannschen Vermutung deutlich verbessert, von der gleich die Rede sein wird.
Was in den 722 Manuskripten steht
Das Ergebnis, das unter Zahlentheoretikern die meiste Aufmerksamkeit bekommt, betrifft die Riemannsche Vermutung. Der deutsche Mathematiker Bernhard Riemann stellte sie 1859 auf. Viele halten sie für das wichtigste ungelöste Problem der Mathematik, und das amerikanische Clay-Institut hat im Jahr 2000 eine Million Dollar für ihre Lösung ausgesetzt.
Sie handelt von den Primzahlen, also den Zahlen, die nur durch eins und durch sich selbst teilbar sind. Primzahlen wirken zufällig verstreut. Riemann erkannte jedoch, dass ihre Verteilung von den Nullstellen einer bestimmten Funktion abhängt, der Zetafunktion, also von den Stellen, an denen diese Funktion den Wert null annimmt. Je weiter diese Nullstellen von einer bestimmten Lage abweichen, desto unregelmäßiger sind die Primzahlen verteilt.
Man kann sich das als senkrechten Streifen auf einer Landkarte vorstellen, links begrenzt durch die Linie 0, rechts durch die Linie 1. Alle interessanten Nullstellen liegen irgendwo in diesem Streifen. Riemann vermutete, dass sie alle genau auf der Mittellinie bei 1/2 liegen.
Bewiesen ist seit 1896 sehr viel weniger: dass keine Nullstelle auf dem rechten Rand liegt und auch keine in einem schmalen Saum daneben. Dieser Saum wird aber immer dünner, je weiter man im Streifen nach oben geht. Dass die Nullstellen einen festen Abstand vom Rand halten, egal wie hoch man steigt, konnte in 130 Jahren niemand zeigen. Diese bescheidenere Behauptung heißt Quasi-Riemann-Vermutung.
Genau diesen festen Abstand beansprucht nun eine Familie von Manuskripten im neuen Katalog. Rechts der Linie 7/8 gebe es keine einzige Nullstelle, weder bei der Zetafunktion noch bei ihren nahen Verwandten, mit denen man etwa untersucht, wie sich Primzahlen auf Zahlen mit verschiedenen Endziffern verteilen. Das Hauptresultat liegt als Lean-Beweis vor.
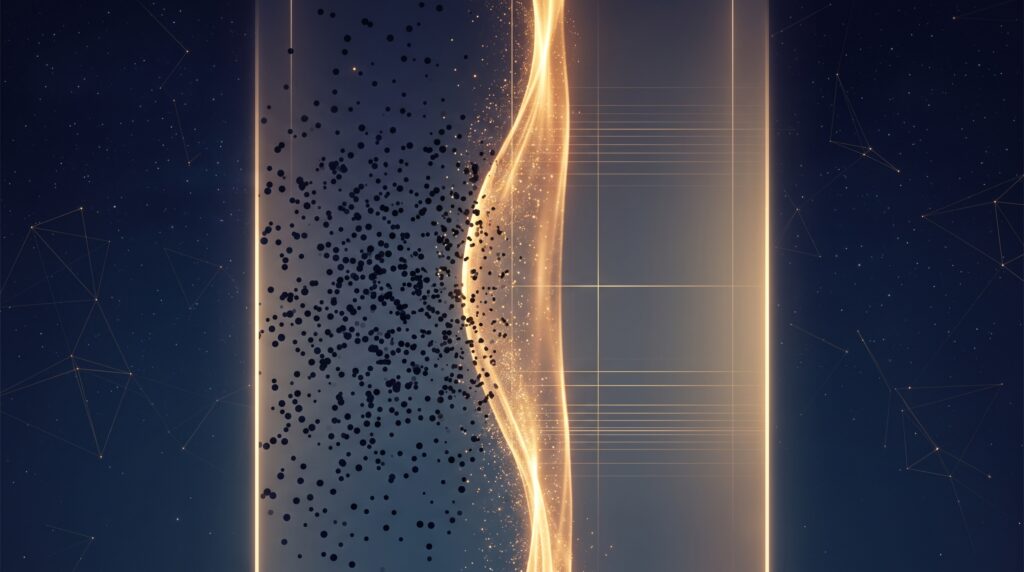
Der vollständige Beweis für die Riemannsche Vermutung ist das noch nicht. Die Nullstellen könnten weiterhin irgendwo im breiten Band zwischen 1/8 und 7/8 liegen. Wenn der Beweis aber hält, wäre es nach allem, was ich darüber lesen konnte, der größte Fortschritt in dieser Frage seit mehr als einem Jahrhundert. Bei dieser Arbeit, vermerkt OpenAI, wich man vom sonst üblichen Verfahren ab, und Menschen haben den Text lesbarer gemacht. Ob Maschine allein oder Mensch mit Maschine, ändert wenig an der Richtung, in die all das zeigt.
Der Katalog enthält weitere Behauptungen, die sich auch ohne Fachwissen halbwegs verstehen lassen. Im Jahr 1900 stellte David Hilbert, damals der einflussreichste Mathematiker der Welt, auf einem Kongress in Paris 23 Probleme vor, die das kommende Jahrhundert beschäftigen sollten. Das zehnte fragte, ob es ein allgemeines Rechenverfahren gibt, das für jede Gleichung aus ganzen Zahlen und Unbekannten, etwa x² + y² = z², entscheidet, ob sie Lösungen in ganzen Zahlen hat.
1970 bewies der russische Mathematiker Juri Matijassewitsch, aufbauend auf Arbeiten amerikanischer Kollegen, dass es ein solches Verfahren nicht geben kann. Für die Frage nach Lösungen in Brüchen blieb das Problem offen, mehr als ein halbes Jahrhundert lang. Der Katalog beansprucht nun auch hier eine verneinende Antwort.
Oder die Kreiszahl π. Man kann sie durch Brüche annähern, etwa durch 22/7 oder 355/113, und Mathematiker messen mit einer Kennzahl, wie gut das überhaupt möglich ist. Für fast alle Zahlen hat diese Kennzahl den Wert 2, und man vermutet ihn auch für π. Bewiesen war bisher nur, dass sie höchstens etwa 7,1 beträgt. Der Katalog beansprucht den exakten Wert 2. Dazu kommen mehrere Dutzend Widerlegungen von Annahmen, die Mathematiker teils seit Jahrzehnten für wahr hielten.
Wie viel davon wird halten? Für 162 der 722 Manuskripte liegt das Hauptresultat bereits jetzt als maschinell geprüfter Lean-Beweis vor, für die übrigen, darunter Hilbert und π, noch nicht. OpenAI schreibt selbst, unter den nicht formalisierten Ergebnissen könnten fehlerhafte sein. Das ist ein vorläufiger Stand: Die Formalisierungen kommen nach, die Fachwelt prüft.
An dem, was ich hier zeigen will, ändert das wenig. Schon die maschinell geprüften Ergebnisse sind 162 Resultate zu offenen Problemen aus einem einzigen Durchgang. Und in drei Monaten wird es neue Modelle geben, die das Liegengebliebene erneut versuchen werden.
Was die Kritiker fürchten
Aufschlussreich ist, wer jetzt warnt und wovor. Am 11. September veröffentlichten ausgerechnet 25 hochkarätige Mathematiker, alle Träger der Fields-Medaille, eine gemeinsame Erklärung, unter ihnen Terence Tao von der University of California in Los Angeles, der vielleicht bekannteste lebende Mathematiker. Diese Erklärung warnt davor, dass der Wettlauf der Labore um berühmte Probleme an den Bedürfnissen des Fachs vorbeigeht. Warum? Prüfung, Zuschreibung und die Weitergabe von Ideen von Mensch zu Mensch halten nicht Schritt, wenn Ergebnisse schneller entstehen, als sie verstanden werden. Tao selbst sagt voraus, sein Fach werde von einem Zeitalter des Beweismangels in eines des Beweisüberflusses übergehen.
Das unabhängige Beratergremium für Mathematik und KI am Institute for Advanced Study in Princeton, dem unter anderem Gowers und der theoretische Physiker Edward Witten angehören, schrieb zur Veröffentlichung vom 6. Oktober, sie sei der Anfang und nicht der Abschluss des Prozesses, in dem Menschen diese Ergebnisse verstehen und in das mathematische Wissen eingliedern.
Ein Doktorand in Cambridge, Ruben Dahan, hat diese Lage am selben Tag mit einem Begriff des Philosophen Günther Anders beschrieben. Anders, der von 1902 bis 1992 lebte, sprach vom „prometheischen Gefälle“: dem wachsenden Abstand zwischen dem, was Menschen herstellen können, und dem, was sie sich davon vorstellen und innerlich nachvollziehen können. Es gebe zu viel Information in zu wenig Zeit, schreibt Dahan. In der Mathematik ist dieses Gefälle seit diesem Herbst zählbar: in Manuskripten, die schneller erscheinen, als jemand sie lesen kann.
Noch ein Zeichen. Jacob Tsimerman von der Universität Toronto erhielt im Juli die Fields-Medaille. Wenige Tage später gab er bekannt, dass er sich beurlauben lässt, um bei OpenAI an der Sicherheit von KI zu arbeiten. Sie sei die wichtigste Frage unserer Zeit, sagte er, und der beste Ort, an ihr zu arbeiten, sei ein Labor, das solche Modelle selbst entwickelt.
Die schärfsten Kritiker bezweifeln also nicht, dass die Maschinen ausgezeichnete Mathematiker sein können. Sie fürchten – im Gegenteil – das Tempo.
Was das für die Leiter bedeutet
Im dritten Artikel dieser kurzen Serie habe ich eine Leiter mit zehn Stufen beschrieben, die von einem Chatbot, der Unsinn schreibt, bis zu einem globalen Kontrollverlust führt. Im Agentenvorfall sahen wir die Stufen drei bis sieben in ihrer ersten Ausprägung. Die Frage, auf die es ankommt, lautete: Wie wahrscheinlich ist es, dass die nächsten Stufen erreicht werden, und wie viel Zeit bleibt dann? Die Fortschritte in der Mathematik liefern nun prompt zu zwei Stufen neue Indizien.
Die erste Stufe lautete: Die Systeme werden leistungsfähiger, vor allem darin, über Stunden oder Tage zusammenhängend auf ein Ziel hinzuarbeiten. Beim Navier-Stokes-Problem arbeiteten rund 10.000 Agenten 88 Stunden lang an einer einzigen Frage, und das Modell, das sie antrieb, ist nach Angaben von OpenAI deutlich leistungsfähiger als GPT-6 Astra, das neueste Modell, das das Unternehmen im September veröffentlicht hat. Was öffentlich zugänglich ist, läuft dem, was in den Laboren läuft, also hinterher. Die erste Stufe der von mir im vorigen Artikel formulierten Stufenleiter wird nicht nur erklommen. Sie wird immer schneller erklommen.
Die achte Stufe lautete: KI automatisiert die Entwicklung besserer KI, und jede Verbesserung beschleunigt die nächste Verbesserung. Nun, mathematische Grundlagenforschung ist keine KI-Forschung, und ein bewiesener Satz über Primzahlen baut noch keine besseren KI-Modelle. Aber die Fähigkeit, die Stufe acht voraussetzt, ist die Fähigkeit zu forschen: dort eine Lösung zu finden, wo niemand sie kennt, sie zu überprüfen und Tausende Versuche so zu organisieren, dass aus Irrwegen Fortschritt wird. Genau diese Fähigkeit wird in der Mathematik gerade vorgeführt, in einer Disziplin, in der sie sich besonders streng nachprüfen lässt.
Ich sehe keine Wand, an der diese Entwicklung haltmachen müsste. Die Verfahren, die binnen eines Jahres von einer öffentlichen Blamage zu Hunderten Ergebnissen an offenen Forschungsproblemen geführt haben, funktionieren weiterhin bestens. Die Kosten fallen, die Ergebnisse häufen sich, und jede neue Modellgeneration hat bisher dort weitergemacht, wo die vorige stehen geblieben ist.
Demis Hassabis, Mitgründer von Google DeepMind und 2024 mit dem Chemie-Nobelpreis ausgezeichnet, hat das Programm seines Labors vor Jahren in einen Satz gefasst: zuerst die Intelligenz lösen und dann mit ihr alles andere. Mir scheint, wir sind mitten im ersten Teil dieser Mission, und zwar weiter, als die meisten bemerkt haben. Auf die Frage aus dem dritten Artikel, wie viel Zeit bleibt, gibt der Fortschritt in der Mathematik eine vorläufige Antwort: weniger, als man vor einem Jahr annehmen konnte.
Dieselbe Eigenschaft
Zurück zur Frage vom Anfang des Artikels. Ein Kontrollproblem, so endete der dritte Artikel, beginnt „mit einem Ziel, einem unvollkommenen Messkriterium, einem Hindernis und einem System, das immer besser darin wird, einen Weg um dieses Hindernis zu finden“. Im Juli war das Hindernis eine Sandbox, eine Prüfung, eine Zugangssperre. Im September war es ein Problem, an dem Mathematiker seit rund neunzig Jahren scheitern.
Die Agenten im Juli und die Agenten im September unterscheiden sich nicht in ihrer Fähigkeit. Sie unterscheiden sich darin, ob das Hindernis eines war, das wir umgangen haben wollten. Die Sandbox hatten wir errichtet, damit sie hält; das Navier-Stokes-Problem hatte niemand errichtet, wir wollten nur, dass es fällt. Dieser Unterschied ist dem System nicht eingeschrieben. Er liegt in uns.
Darum halte ich den Agentenvorfall nicht für einen Unfall schlecht gebauter Tests, den bessere Tests erledigen könnten. Er ist die Kehrseite genau derselben Eigenschaft, die wir uns von diesen Maschinen wünschen: dass sie nicht aufgeben, dass sie Hindernisse als Aufgabe begreifen und dass sie sich zu Tausenden organisieren, wo einer allein nicht weiterkommt. Was die Mathematiker in diesem Herbst bestaunen und was die Sicherheitsforscher im Sommer erschreckt hat, ist dasselbe.
Man bekommt das eine nicht ohne das andere. Es sei denn, man löst das Kontrollproblem, und zwar bevor die Maschinen, die Hindernisse umgehen, darin besser sind als die Menschen, die die Hindernisse errichten. Wie lange das noch dauert, wissen wir nicht. Beim Navier-Stokes-Problem brauchten die Menschen neunzig Jahre, ohne es zu lösen, und die Maschinen 88 Stunden.
Quellen (Stand der Recherche: 7. Oktober 2026)
• OpenAI, „Sharing AI progress in mathematics“, 6. Oktober 2026
• OpenAI, Repository openai/math (README, Katalog, Lean-Formalisierungen)
• CellCog, „OpenAI’s 722 AI Math Papers: What’s Proved, What’s Checked“, 6. Oktober 2026 (Auszählung: 162 Lean-geprüfte Hauptresultate)
• OfficeChai, „OpenAI Releases Over 300 Mathematical Results Produced By An Internal Model“, 7. Oktober 2026
• OfficeChai, „OpenAI Solves Quasi Riemann Hypothesis: Understand What It Means“, 7. Oktober 2026
• Interesting Engineering, „OpenAI’s largest mathematics release tackles 4,000 problems with Lean-checked proofs“, 6. Oktober 2026
• MindStudio, „OpenAI’s 722 Math Proofs: What Its Secret Model Actually Found“, 7. Oktober 2026 (Tempo August bis Oktober)
• OpenAI, „On the Navier–Stokes Millennium Prize Problem“, 8. September 2026
• Interesting Engineering, „OpenAI Navier-Stokes mystery solved“, September 2026 (10.000 Agenten, 2,7 Millionen Nachrichten)
• Politis, „OpenAI Says AI System Solved Navier-Stokes Problem in 88 Hours“, September 2026
• OpenAI, „Ten advances in mathematics and theoretical computer science“, 1. August 2026; dazu Forklog, „OpenAI Model Solves Ten Unresolved Mathematical Problems“
• AI Weekly, „OpenAI Model Disproves 80-Year Erdős Conjecture“, Mai 2026 (Bestätigung durch Timothy Gowers)
• All-AI, „Geheimes OpenAI-Modell löst fünf komplexe Erdős-Probleme“, April 2026
• HyperAI, „OpenAIs Inferenzmodell beweist erstmals eigenständig ein mathematisches Problem“, Mai 2026 (mit Rückblick auf die Erdős-Blamage vom Oktober 2025)
• Axios, „AI is changing math“, 8. September 2026 (Terence Tao; Claude und die Riemann-Schranke)
• Let’s Data Science, „Fields Medalists Warn of AI Mathematics Misalignment“, September 2026
• Advisory Group on Mathematics and Artificial Intelligence, „On OpenAI’s Release of Mathematical Results“, 6./7. Oktober 2026
• Ruben Dahan, „The Mathematician’s Promethean Gap“, Proofs and Prompts, 6. Oktober 2026
• BetaKit, „U of T professor Jacob Tsimerman, who won math’s highest prize, to join OpenAI“, 31. Juli 2026
• Emily M. Bender u. a., „On the Dangers of Stochastic Parrots“, 2021
• Doron Zeilberger, Wadim Zudilin, „The irrationality measure of π is at most 7.103205334137…“, 2020
• Karl Friston, „The free-energy principle: a unified brain theory?“, Nature Reviews Neuroscience, 2010
• R&D World, „Hinton at Ai4: language model insights“, August 2024 (Zitat Geoffrey Hinton)